En Por qué el chunking rompe a tu agente de código conté por qué los agentes de código a veces responden como si les faltara la mitad del archivo. En KC-RAG: recuperar código con inteligencia estructural expliqué la idea detrás de la solución. Este post es el "vale, ¿y cómo funciona esto de verdad, sin tecnicismos?".
Voy a evitar la jerga todo lo posible. Si en algún momento suena a laboratorio, es que me expliqué mal — avísame.
La idea en una frase
En vez de que el agente abra archivos enteros a ciegas y adivine qué parte le sirve, yo ya tengo un mapa de todo el código de antemano: qué función existe, dónde está, y qué otras funciones llama. Cuando el agente pregunta algo, no le doy el archivo — le doy exactamente el trozo del mapa que necesita, ya recortado.
Es la diferencia entre darle a alguien un libro entero para que encuentre un dato, o darle directamente la página subrayada.
Paso 1 — hacer el mapa una sola vez
Antes de que nadie pregunte nada, recorro todo el proyecto y extraigo cada función y cada clase como una pieza completa — nunca cortada a la mitad — junto con quién llama a quién. Eso es el mapa. Se hace una vez, en segundos, y luego solo se actualizan las partes que cambian cuando tú editas código, no el proyecto entero cada vez.
Paso 2 — buscar de tres formas a la vez, no de una
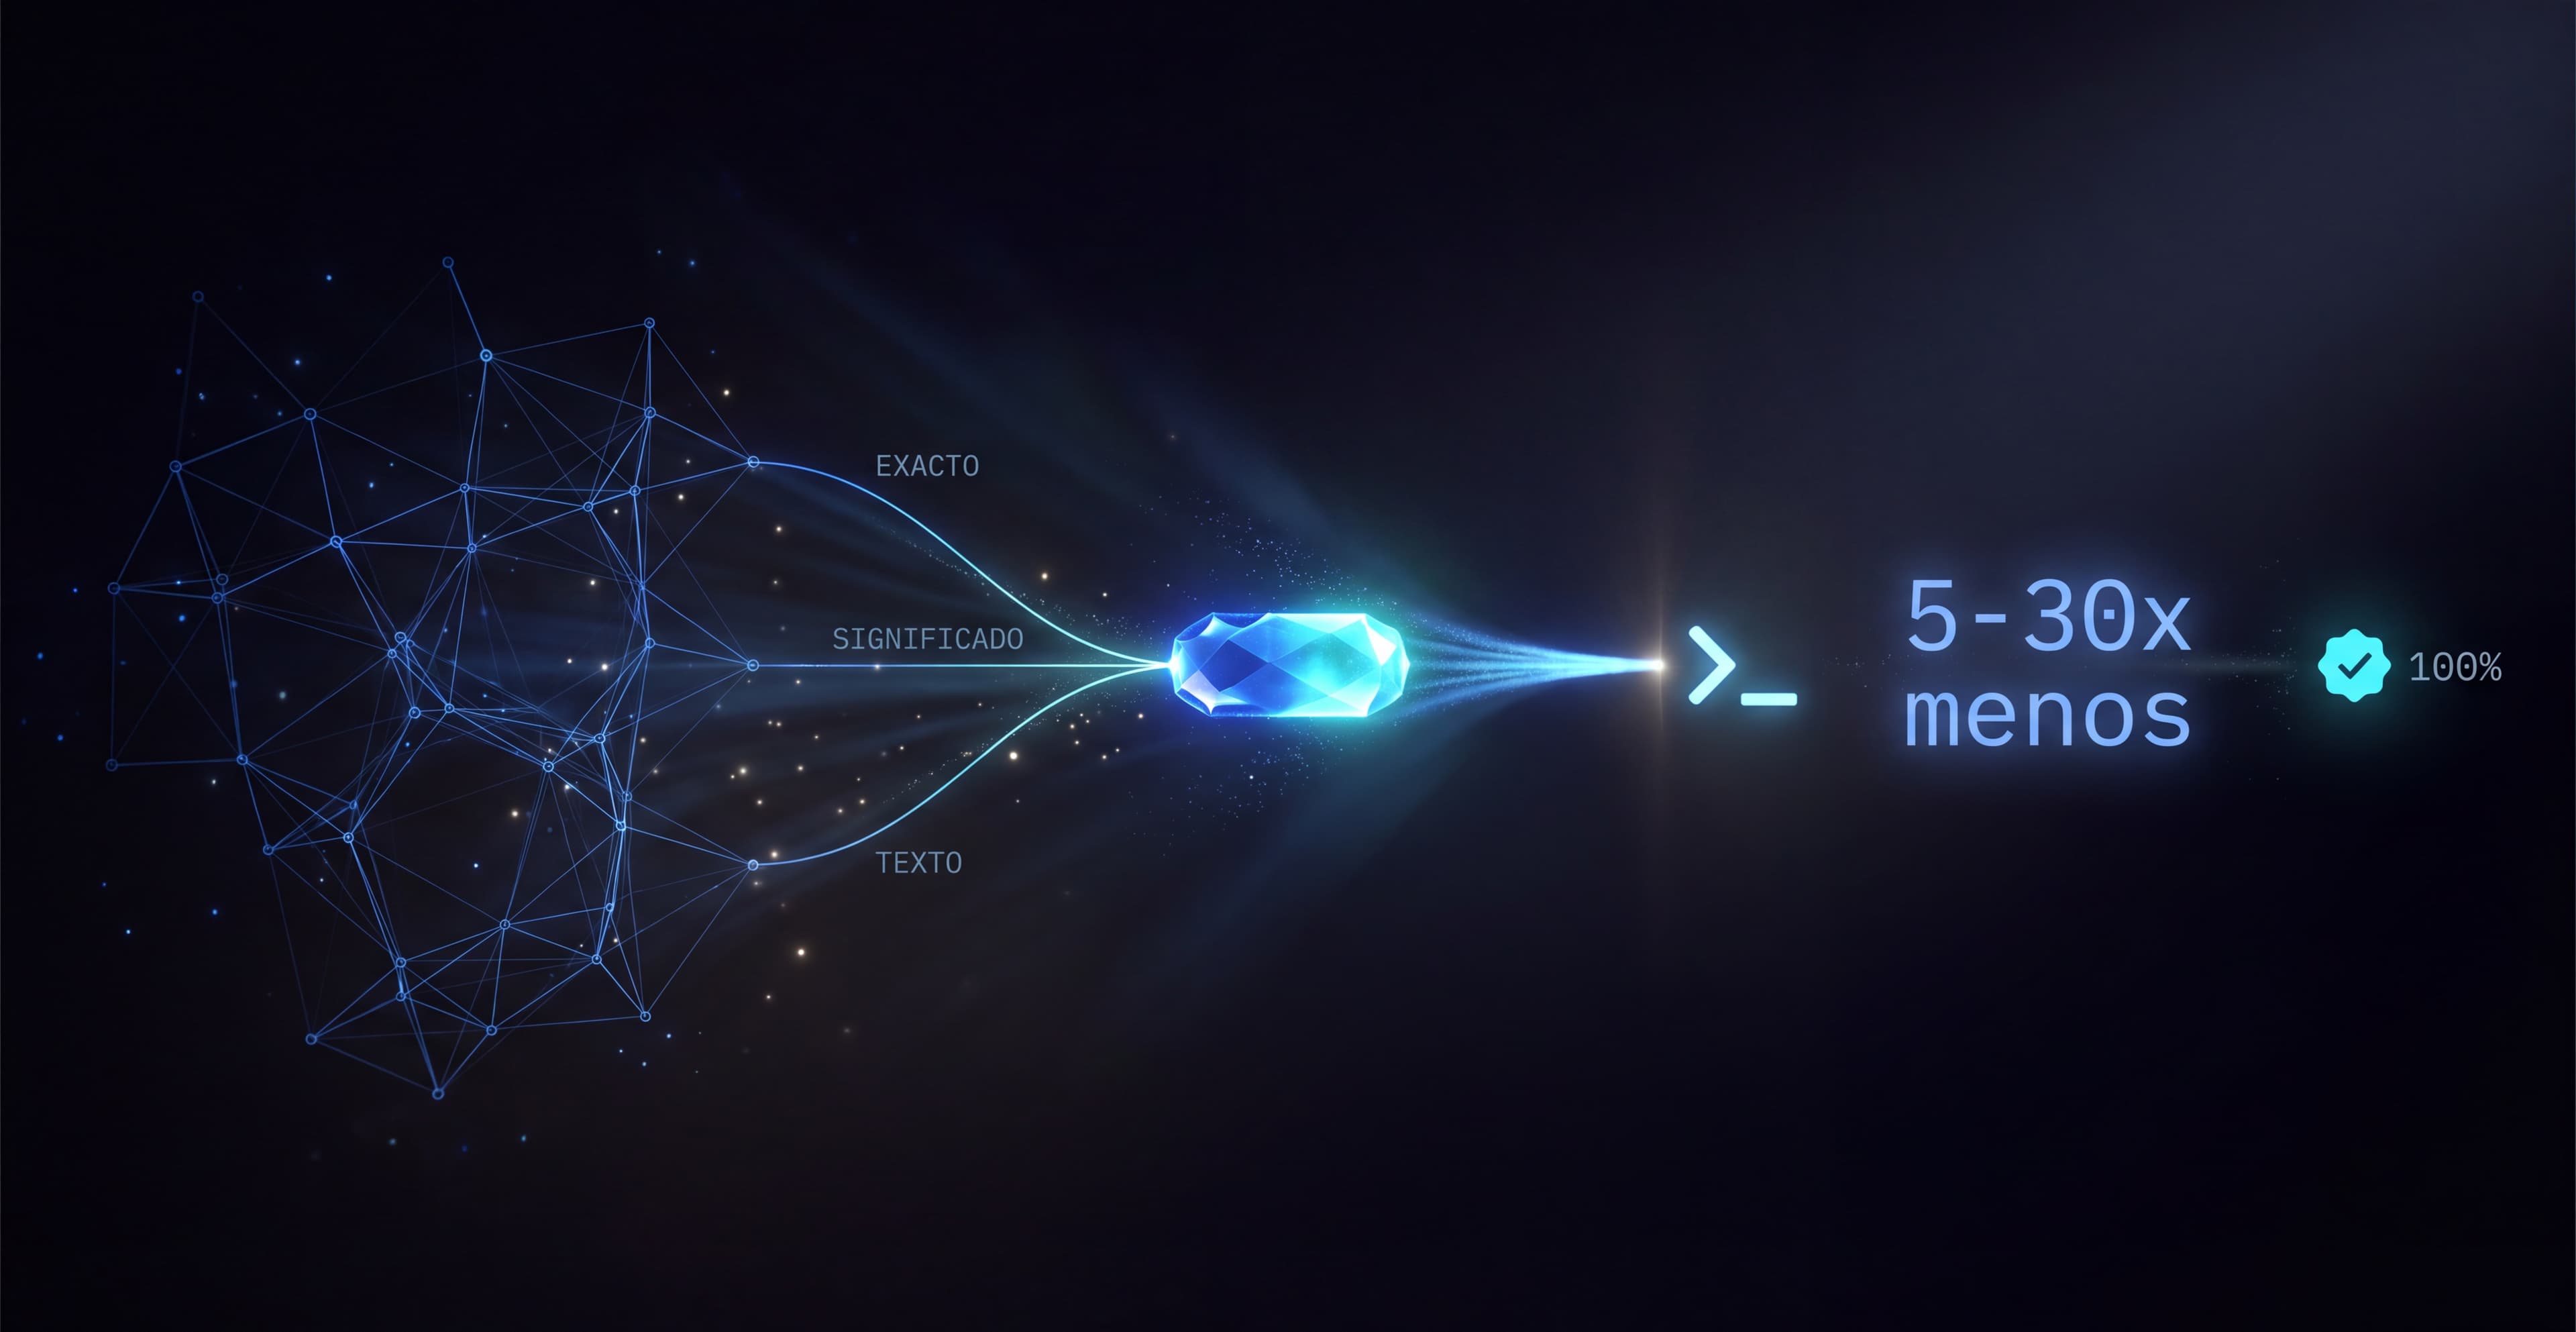
Cuando llega una pregunta, no confío en un solo método de búsqueda porque cada uno falla distinto. Busco el nombre exacto — si preguntas por verifyUser, esa función aparece sí o sí. A la vez busco por significado, para cuando preguntas con tus propias palabras y no el nombre literal. Y busco también por coincidencia de texto, el punto medio entre las dos anteriores. Me quedo con lo que varias de las tres formas de buscar señalan a la vez, no con lo primero que aparece.
Y encima, priorizo las funciones que más se usan dentro del propio proyecto — si media base de código llama a una función, seguramente es más relevante que una que nadie toca.
Paso 3 — darle solo lo que hace falta para ESA tarea
Entender qué hace una función no es lo mismo que prepararte para editarla, y no es lo mismo que escribir código nuevo desde cero. Así que reconozco qué tipo de tarea es y ajusto cuánto contexto entrego: para entender, basta con la función y un resumen de lo que toca; para editar con seguridad, incluyo también el código completo de lo que esa función usa por dentro; para generar algo nuevo, ni falta hace ver lógica — solo la estructura del proyecto.
El resultado se lo entrego al agente ya listo, con una instrucción clara: "esto ya está aquí, no vuelvas a abrir el archivo". Ese detalle, que suena tonto, es el que más dinero ahorra — un agente al que no se lo dices claro tiende a releer el archivo "por si acaso", y eso duplica el gasto.
Paso 4 — antes de tocar algo, saber qué se rompe
Hay una segunda función, separada de la búsqueda: antes de editar algo le puedes preguntar directamente "¿qué se rompe si toco esto?" y te contesta con la lista real de todo lo que depende de esa pieza — archivo y línea exactos. No es el modelo opinando ni adivinando: es un recorrido real sobre el mapa que ya construí. Cero posibilidad de que se lo invente.
Los números, sin adornar
Esto es lo que cambió, medido, no calculado a ojo:
| Qué medí | Cómo lo comprobé | Resultado |
|---|---|---|
| Peso de lo que recibe el agente por pregunta | vs. abrir el archivo completo | 3-20% del tamaño → 5 a 30 veces menos |
| Mapa de "quién llama a quién" | comparado función por función con las herramientas oficiales de Python y TypeScript | 100% en Python · +99,9% en TypeScript |
| Gasto total en tareas pesadas | agente real, tareas reales de principio a fin | −30% |
| Gasto total en tareas normales | mismo tipo de medición | igual, nunca más caro |
| Tiempo de respuesta | mismo tipo de medición | −14% de media |
No prometo "ahorra siempre un montón" porque no es verdad y ya lo comprobé con datos que decían lo contrario seis veces antes de dar con la versión que sí funciona. La promesa real es más aburrida y más honesta: nunca te sale más caro, casi nunca falla, y en las tareas grandes se nota de verdad.
Un ejemplo, para que se entienda del todo
Le pides a un agente que añada login con Google a una función login() que ya existe.
Sin el mapa: el agente abre el archivo entero de autenticación, busca por similitud "login google" y recibe trozos sueltos sin conexión entre ellos — no ve claro qué usa login() por dentro. Propone algo que rompe la validación existente porque no la vio completa. Coste total, contando el intento fallido: unos 8.000 tokens.
Con el mapa: localizo login() al instante, y como ya sé qué llama por dentro (validar contraseña, crear sesión), se lo entrego todo junto, ya recortado a lo relevante. El agente ve la lógica completa de una y propone algo que no rompe nada. Coste total: unos 2.500 tokens — y funciona a la primera.
Por qué te lo puedo asegurar así de directo
Porque no me creo mis propios números sin comprobarlos: el mapa se revisa automáticamente cada vez que cambio algo, comparándolo contra herramientas que no son mías. Si un cambio hace que el mapa se equivoque aunque sea un poco, ese cambio no se publica. Es la misma disciplina con la que reviso este blog: si un dato no lo puedo comprobar, no lo escribo.